Kernpunkte & Schnellleser-Modus
- Rohdaten verbrennen unsauber: Unstrukturierte Notizen, PDFs und Weblinks besitzen für sich allein noch keinen Mehrwert – sie verstopfen KI-Modelle und Entscheidungsprozesse.
- Die 5 Stufen der Raffinierung: Erst durch Ordnen, Aktualisieren, Prüfen, thematisches Einordnen und Festhalten von Urheberschaft entsteht ein belastbarer Wissenskorpus.
- Brennwert & Lagerfähigkeit: Geklärtes Wissen wird in Klassen eingeteilt – nach seiner Lenkungswirkung für KI-Prompts/Entscheidungen und seiner zeitlichen Haltbarkeit.
Zusammenfassung Der vielzitierte Satz „Daten sind das neue Öl“ greift zu kurz: Ungefilterte Rohdaten sind unbrauchbar für präzise Entscheidungen oder anspruchsvolle KI-Systeme. Erst ein systematischer Veredelungsprozess – das Raffinieren – verwandelt verstreute Dokumente und Notizen in hochwertigen Treibstoff. Mit einem lokalen Markdown-System in Obsidian und der Bewertung nach Brennwert (Lenkungskraft) und Lagerfähigkeit (Gültigkeitsdauer) entsteht eine unabhängige, zukunftssichere Wissensinfrastruktur für Mensch und Maschine.
Seit Jahren predigt die Digitalbranche denselben Leitspruch: „Daten sind das neue Öl.“ Unternehmen horten PDFs, Teams speichern zahllose Links in Chatverläufen, und auf Festplatten stapeln sich Notizen.
Doch wer schon einmal versucht hat, rohes Erdöl direkt in den Tank eines modernen Motors zu füllen, kennt das Ergebnis: Der Motor streikt.
Genauso verhält es sich mit Künstlicher Intelligenz, Retrieval-Augmented Generation (RAG) und unternehmerischen Entscheidungen. Rohdaten liegen verstreut vor, sind unterschiedlich alt, widersprüchlich, redundant oder ohne Kontext. Ihr wahrer Wert entsteht nicht durch ihr schieres Volumen, sondern ausschließlich durch ihre Raffinierung.
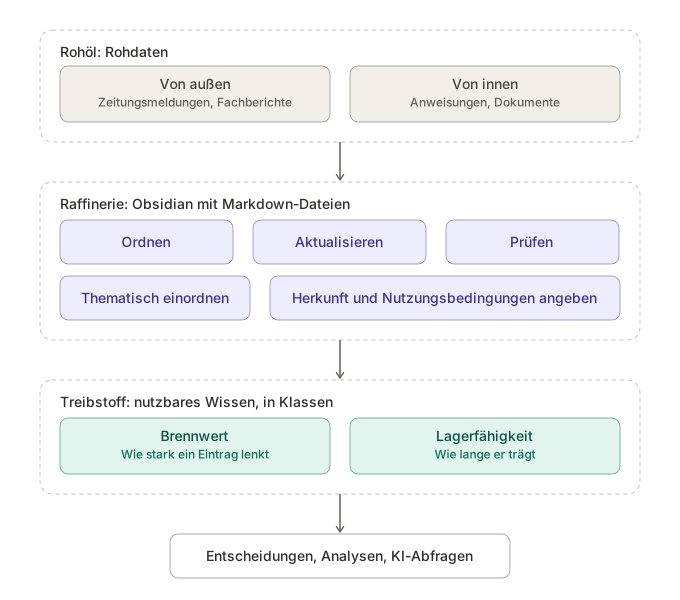
Was bedeutet Daten-Raffinierung in der Praxis?
In einer industriellen Raffinerie wird Rohöl durch Destillation und chemische Prozesse in gebrauchsfertige Produkte getrennt: von leichtem Kerosin über Benzin und Diesel bis hin zu Bitumen.
Übertragen auf das eigene Wissensmanagement durchläuft jedes Stück Information fünf aufeinander aufbauende Veredelungsstufen:
- Ordnen: Formate vereinheitlichen, Dubletten entfernen und chaotische Informationsschnipsel in eine klare Grundstruktur überführen.
- Aktualisieren: Veraltete Stände identifizieren, überholte Annahmen ausmisten und Versionsstände nachvollziehbar dokumentieren.
- Prüfen: Fakten gegenchecken, Plausibilität bewerten und Primärquellen verifizieren.
- Thematisch einordnen: Querverbindungen herstellen, Taxonomien zuweisen und semantische Brücken zu bestehendem Wissen schlagen.
- Herkunft & Nutzungsrechte sichern: Festhalten, woher eine Information stammt (Provenance), wer die Urheberrechte hält und unter welchen Lizenzbedingungen sie intern oder für KI-Training genutzt werden darf.
Erst nach diesem Durchlauf verwandelt sich die Datenflut in einen verlässlichen Wissensbestand, der von KI-Agenten ohne Halluzinationen abgefragt werden kann.
Die Architektur: Markdown als Format, Obsidian als Lager
Viele digitale Wissensspeicher scheitern an proprietären Cloud-Datenbanken. Ändert ein Anbieter seine Geschäftsbedingungen, Schnittstellen oder Preise, sitzt man in der Falle (Vendor-Lock-in).
Obsidian ist deshalb kein klassisches Notiztool, sondern ein Local-First-Wissensmanagementsystem, das darauf ausgelegt ist, Gedanken dauerhaft, vernetzt und unabhängig von Plattformen nutzbar zu halten:
- Echte Datensouveränität:
Alle Notizen liegen als einfache Markdown-Textdateien (.md) im eigenen, lokalen Dateiordner (Vault) – nicht in einer fremden Cloud-Datenbank. Das garantiert die volle Kontrolle: Sie können Ihre Daten jederzeit migrieren, per Skript bearbeiten oder mit anderen Tools weiterverwenden. Für sensible Firmeninterna, journalistische Recherchen oder Projekte mit strengen DSGVO-Anforderungen ist das ein unschätzbarer Vorteil. - 100 % Offline & rasend schnell:
Die Anwendung arbeitet vollständig lokal auf dem eigenen Rechner. Selbst Bestände mit Zehntausenden Dokumenten laden in Sekundenbruchteilen – zuverlässig auch unterwegs oder bei instabiler Internetverbindung. - Vernetztes Denken durch Wikilinks & Graph-Ansicht:
Über bidirektionale Wikilinks ([[Konzept]]) verbinden sich Notizen wie Synapsen. Die integrierte Graph-Ansicht visualisiert das gesamte Beziehungsgeflecht und deckt verborgene Querverbindungen auf – ideal für assoziatives, forschendes Arbeiten. - Maschinenlesbarkeit für KI-Agenten & Skripte:
Durch standardisierte Metadaten im YAML-Frontmatter (am Kopf jeder Datei) wird jede Notiz für Maschinen lesbar. Eigene KI-Agenten, RAG-Pipelines oder Dataview-Abfragen können den Wissensbestand präzise nach Datum, Quellen, Urheberrechten oder Themen filtern. - Modulares Ökosystem:
Mit über 1.200 Community-Plugins lässt sich das System vom schlichten Notizbuch bis zur datenbankähnlichen Wissenszentrale ausbauen (inklusive Kanban-Boards, Zeitachsen und lokaler KI-Assistenten).
┌─────────────────────────────────────────────────────────────┐
│                    DIE OBSIDIAN-ARCHITEKTUR                 │
├──────────────────────────────┬──────────────────────────────┤
│ 📥 MATERIAL VON AUSSEN       │ 📝 MATERIAL VON INNEN        │
│ Fachberichte, Primärquellen, │ Eigene Anweisungen, Thesen,  │
│ Gesetzestexte & Meldungen    │ Systemdesigns & Prompt-Logs  │
├──────────────────────────────┴──────────────────────────────┤
│ ⚙️ DER LOKALE VAULT (Markdown + Wikilinks + YAML-Metadaten) │
└─────────────────────────────────────────────────────────────┘
Ehrliche Einordnung:
Obsidian ist kein Tool für die flüchtige Echtzeit-Teamzusammenarbeit (hier sind Google Docs oder Notion im Vorteil) und erfordert durch Markdown und Verlinkungslogik etwas Einarbeitung. Doch überall dort, wo es um langfristigen Wissensaufbau, datenschutzkonforme Recherche und unabhängige Gedankenarbeit geht, ist dieser lokale Ansatz unschlagbar.
💡 Meine Praxis-Empfehlung: Schon in der kostenlosen Version schlichtweg „Gold wert“
Wie der fundierte Überblick im Wikipedia-Artikel zu Obsidian (Software) zeigt, wurde das System von Shida Li und Erica Xu von Grund auf mit einem klaren Architekturprinzip entworfen: Ein plattformübergreifendes Wissensmanagementsystem für Windows, macOS, Linux, iOS und Android zu schaffen, das zu 100 % lokal auf offenen Markdown-Dateien arbeitet.Für die persönliche Nutzung ist die Kern-App dauerhaft kostenlos und uneingeschränkt nutzbar. Man benötigt weder kostenpflichtige Abos noch Cloud-Dienste, um ein hochprofessionelles, vernetztes Wissensarchiv aufzubauen. Für jeden, der mit Daten, Recherchen oder KI-Prompts arbeitet, ist diese Software ein echtes Fundament: Bei Radio Rüsselsheim haben wir einen Agenten xRAK mit .md-Dateien aufgebaut.
Brennwert und Lagerfähigkeit: Die zwei Dimensionen geklärten Wissens
Um zu entscheiden, welches Wissen in einen KI-Prompt, eine Analyse oder eine strategische Entscheidung einfließt, reicht ein einfaches Ablagedatum nicht aus. Wir klassifizieren jedes Dokument nach zwei messbaren Eigenschaften:
┌─────────────────────────────────────────────────────────────┐
│                   DAS KLASSIFIZIERUNGS-MODELL               │
├──────────────────────────────┬──────────────────────────────┤
│ 🔥 DER BRENNWERT            │ ⏳ DIE LAGERFÄHIGKEIT        │
│ Wie stark lenkt der Eintrag  │ Wie lange trägt die Aussage, │
│ eine Antwort/Entscheidung?   │ bevor sie verfällt?          │
└──────────────────────────────┴──────────────────────────────┘
- Der Brennwert (Lenkungswirkung):
Wie maßgeblich ist diese Information? Eine verbindliche Verfahrensanweisung oder ein gesetzlicher Schwellenwert (z. B. aus dem EU AI Act) besitzt höchsten Brennwert – sie bestimmt die Richtung zwingend. Eine informelle Randnotiz besitzt niedrigen Brennwert. - Die Lagerfähigkeit (Halbwertszeit):
Wie lange bleibt die Aussage gültig? Fundamentale Prinzipien (wie Kybernetik oder mathematische Transformer-Grundlagen) besitzen eine jahrelange Lagerfähigkeit. Eine Tagesmeldung über ein Server-Update verfällt nach wenigen Wochen.
Wissen mit hohem Brennwert und hoher Lagerfähigkeit bildet das stabile Fundament für jeden KI-Assistenten.
Häufig gestellte Fragen (FAQ)
Brauche ich teure Enterprise-Software, um eine Datenraffinerie aufzubauen?
Nein. Das Geheimnis liegt nicht in teuren Lizenzverträgen, sondern in der Disziplin der Kuration. Textdateien in Markdown und ein lokaler Editor wie Obsidian genügen vollständig, um ein hochprofessionelles System aufzusetzen, das jedem Cloud-Silo an Flexibilität überlegen ist.
Wie profitieren KI-Agenten und RAG-Systeme von diesem Ansatz?
Sprachmodelle spiegeln die Qualität der gelieferten Kontextdaten wieder („Garbage in, Garbage out“). Wird ein KI-Agent mit kuratiertem Wissen gefüttert, dessen Herkunft, Brennwert und Aktualität geprüft sind, sinkt die Halluzinationsrate gegen Null.
Wie viel Zeit erfordert die laufende Raffinierung?
Raffinierung ist kein monatlicher Großputz, sondern ein kontinuierlicher Arbeitsschritt bei der Informationsaufnahme. Wer sich angewöhnt, beim Speichern einer Information direkt Quelle, Datum und Relevanz-Tags zu vergeben, spart bei späteren Recherchen und KI-Abfragen ein Vielfaches der Zeit ein.
Dieser Text ist im Dialog zwischen Mensch und KI entstanden: Gedanken, Analogie und Praxis stammen von Achim Weidner, die redaktionelle Schärfung und die Visualisierung wurden im Zusammenspiel mit Claude und Antigravity realisiert.